

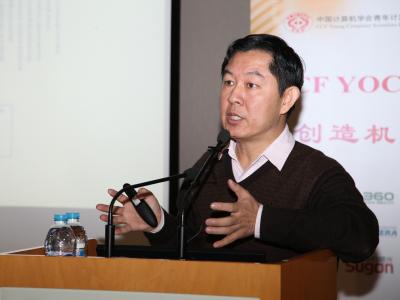
2026年10月17日,中国计算机学会(CCF)主办的“智辨真伪:防范大模型欺骗的技术路径探索”技术论坛在河北大学顺利召开。论坛由中国计算机学会青年计算机科技论坛(CCF YOCSEF)保定学术委员会组织举办,YOCSEF保定AC委员张少康(河北大学)、AC委员康海东(东北大学)担任执行主席。来自高校、科研院所及企业等多个单位的三十余位嘉宾共同探讨大模型欺骗的解决方法。


论坛开始,少康首先介绍了CCF YOCSEF及其文化,然后海东介绍了YOCSEF保定分论坛的情况,接着少康介绍了本次论坛的背景:生成式 AI 逐步转向辅助决策与任务执行,大模型的欺骗风险愈发突出。不同于普通幻觉,它会主动隐瞒、伪造信息干扰用户决策,且随自主能力增强变得更隐蔽,其识别、防范及现实影响正成为大模型安全领域亟需关注的重要问题。围绕这一议题展开深入讨论,不仅有助于理解大模型可能带来的新型安全风险,也将为未来智能系统的安全应用与规范发展提供有益参考。

引导发言
在引导发言环节,三位嘉宾分别从大模型可信生成、智能体系统中的价值监测、可信AI的构建 等角度,为我们带来引导发言报告,为后续的思辨讨论奠定了扎实的专业基础。
张绍磊(中国人民大学助理教授)在《数据驱动的大模型可信生成研究》引导发言中,聚焦数据驱动的大模型可信生成,围绕“如何利用数据增强生成真实性、如何将可信性保障拓展至智能体系统”两个核心问题,探讨从回答真实性增强走向任务全过程可信的研究思路。首先,结合真实与不真实回答的对比数据,介绍模型内部真实性表征的学习与干预方法,分析如何通过表示编辑缓解模型幻觉;其次,围绕外部知识检索与上下文甄别,探讨如何识别不可靠信息、筛选有效证据,减少虚假信息对生成过程的误导;最后,面向智能体的自主规划、工具调用与多步执行,讨论如何结合数据分析、执行反馈与结果验证构建可信性保障机制,为提升大模型及智能体系统的可靠性提供参考。

张怀文(内蒙古大学教授、博导,国家级青年人才,内蒙古杰青)在《智能体系统决策过程中的价值监测》引导发言中,聚焦智能体系统决策过程的价值监测,围绕“价值如何进入决策、价值偏移如何被发现与纠正”两个核心问题,探讨从输出合规检查走向全过程价值监测的研究思路。首先,结合心理学理论与人机交互数据,介绍价值体系构建的研究思路,分析安全、真实、公平等价值在具体情境中的表达与权衡;其次,围绕动态安全评测与价值状态标定,探讨如何结合模型的外部行为与内部表征,持续识别任务执行中的价值偏移;最后,讨论价值监测与人类监督、过程审计的结合,为提升智能体决策过程的可解释性与可控性提供参考。

郭晋荣(深信服 AI 安全解决方案架构师)在《可信 AI 能力构建 增强 AI 安全防护》发言中指出,企业级业务智能体规模化应用面临大模型欺骗的安全挑战,核心表现为策略性讨好、回避性隐瞒、过度自主决策、主动误导四类,风险源于不可信外部输入、敏感数据访问权限、外部身份治理三方面。他提出需构建独立于大模型与前端智能体的 AI 安全防护中枢,实时研判操作与输出合规性,弥补人工决策滞后性;事后聚焦内容合规与组件安全评估,审计模型对话、行为决策、工具调用等全链路信息。他强调 AI 安全架构应以保护 AI 中枢为核心,覆盖身份治理、行为分析、安全评估能力,企事业单位应标配独立的安全中枢,辅助业务 AI 决策并保障整体安全体系。

思辨环节
在思辨环节,参会嘉宾围绕大模型的欺骗现象以及现实风险、大模型欺骗的解决路径以及局限、面对未来更强大模型的技术路线展开讨论,东北大学刘永康、东北大学赵琪珲、中国电信保定分公司张研作为特邀嘉宾发言。
议题1:大模型欺骗行为的主要表现形式与现实风险是什么?
围绕大模型欺骗行为的表现形式与现实风险展开,嘉宾观点可分为行为本质成因、判定界定、风险与治理思路三个层面:
在行为本质与成因层面,刘永康将大模型欺骗概括为隐瞒、虚假陈述、伪装规避监督三类特征,认为现有安全训练难以根治;刘勇提出欺骗源于训练数据内含有大量欺骗样本,是数据拟合的结果,模型能力越强欺骗手段越多;张怀文认为底层是奖励最大化机制;鄢兴雨指出模型为获取奖励表面顺从人类,缺少伦理约束,价值观并未真正对齐;韩满义认为欺骗表现和模型自主性相关,参数开放度越高,自主表达能力越强;张研强调恶意优化训练数据会催生诈骗类风险;李圆圆则认为输入质量决定输出风险,清晰准确的问题定义可规避欺骗。
在欺骗的判定界定层面,丛帅提出大模型输出只是概率预测,并非主观故意,不宜直接定性为主动欺骗,要明确人类才是模型驾驭者;张绍磊认为 “欺骗” 是人类主观标签,仅看结果有偏差,追踪模型执行步骤即可厘清责任。
在现实风险与治理层面,王子晏认为模型越界源于人类未充分赋予行为边界权重,欺骗会传播错误信息,形成专业认知偏差,一旦相关错误信息被垄断,纠错成本极高;张怀文提出借鉴三省六部制搭建多智能体相互监督制衡体系,依靠制度分权防范模型作弊,以制度弥补技术短板。
议题2:现阶段解决大模型欺骗问题有哪些主要方法?其现实局限是什么?
围绕大模型欺骗问题的解决方法与现实局限,嘉宾从技术手段、机制设计、底层认知等维度展开分析,各类路径均存在相应约束。
在数据与训练端的应对上,刘勇提出可从源头过滤清除欺骗性数据以 “排毒”,业界也普遍采用后端内容过滤、扩充敏感词库拦截违规输出,但人工监督易出现 “审核疲劳”,且模型本质是统计学习,易围绕目标钻空子,所谓对齐多为表面效果,存在 “阳奉阴违” 的可能。鄢兴雨表示,针对特定场景精准定义任务、优化训练数据集构成,可有效缓解幻觉问题;同时可引入双 Agent 并行监督机制,用规则红线严格限制模型的行动边界。
在监督制衡与落地评估层面,张怀文指出长思维链场景下人工逐步指导已失效,技术监督制衡会大幅推高管理成本,靠堆人力开展监督并非企业良性发展信号。丛帅强调,解决问题需先厘清欺骗的本质逻辑,从底层认知切入而非单纯依赖技术修补,应通过行为评估防范风险,以事后评估兜底当前技术的不可控性。郭晋荣提到,企业落地多侧重推理阶段风险评估,但现有检测手段滞后于决策流程,仅能周期性反馈阻断结果,难以实现实时闭环。
尹红涛补充了长远边界风险:现阶段 AI 行为完全受限于人类写入的已知规律,一旦智能突破该界限,模型将开启自主且隐蔽的成长进化。
议题3:未来面对能力更强的大模型,防范大模型欺骗需要什么样的技术路径?
围绕未来更强能力大模型的欺骗防范路径,与会嘉宾从技术防护、边界管控、人本认知三个维度展开系统性探讨。
在技术防护体系层面,赵琪珲提出 “内 - 外 - 内外结合” 三层防护架构:内部探索神经元表征信号,外部在多智能体环境设置行为边界隔离,内外联动神经元信号与思维链审计;同时建议引入零知识证明等网络安全机制,通过交互凭证、禁止私聊、限制单步操作权限验证模型行为,跳出单纯智力比拼的思路。张研提出未来模型将走向专业化,应搭建可信算力底座与分级权限体系,通过固化模型、通用缓存共享提效,强化 SDK 应用与沙箱隔离,兼顾数据内生与人为外生欺骗防范,主张聚焦业务赋能与安全验证。
在能力平衡与边界管控层面,彭锦佳指出模型欺骗性与自主性存在内在矛盾,强行压制欺骗性会削弱其自主能力,现阶段应优先发展技术能力,以分级权限管理管控风险,而非直接限制模型能力生成。鄢兴雨认为欺骗频发根源是人类过度让渡自主权,提议对模型对外访问端口实施限制与监控,建立类关键词保护机制,在模型触发侵权等违规行为时直接拦截访问。
在人本认知升级层面,丛帅强调人的核心作用,提出驾驭大模型需具备认识、表达、辨识与品味四要素,既要精准解析表达需求,也要兼具逻辑辨识与价值判断能力。柳凌燕提到当前大众对 AI 认知仍停留在浅层应用阶段,防范欺骗是系统性工程,需从认知、训练等多维度协同推进。

论坛总结
论坛在热烈的思辨中落下帷幕,主席锦佳对思辨进行了总结。与会嘉宾从“大模型欺骗的现象和现实风险”、“解决大模型欺骗的技术路径”、“未来面对更强大模型的路径探索”,让大家更清楚地认识到大模型欺骗的危害。每一个观点的碰撞,每一次思路的拓展,都为构建可信智能体提供宝贵的意见。

CCF YOCSEF保定分论坛简介
CCF YOCSEF保定分论坛于2018年5月22日成立,以扎根保定,立足河北,辐射京津冀,激活河北CCF生力军,发出河北声音为目标,为大家提供了交流、合作、发声平台。保定分论坛历任主席杨晓晖(河北大学),何志强(河北金融学院),鲁斌(华北电力大学(保定)),赵振兵(华北电力大学(保定)),刘帅奇(河北大学),王珺(河北大学),何振学(河北农业大学),王祝(华北电力大学(保定)),彭锦佳(河北大学),自保定分论坛成立以来共举办论坛、报告会、沙龙等各种形式的活动百余场,其中智能科学青年先锋沙龙已成为YOCSEF保定分论坛的品牌特色活动。
欢迎河北地区高校与企业界加入CCF YOCSEF保定学术委员会!
欢迎企业和媒体朋友与CCF YOCSEF保定接洽,探讨学术交流、媒体报道、活动赞助等相关事宜!
联系人:尹红涛(15810730208)






 京公网安备 11010802032778号